Meta сможет обучать ИИ на контенте сайтов без лицензий
Новые правила Meta, вступающие в силу 30 октября, позволяют компании сканировать и собирать данные с веб-сайтов бизнесов, использующих ее платформы, включая онлайн-издателей. Полученный контент разрешено использовать для разработки, исследований и обучения ИИ-продуктов компании. Изменения затрагивают бизнес-аккаунты в Facebook, Instagram, WhatsApp и Messenger, фактически позволяя Meta обходить традиционные лицензионные соглашения.
Другие новости: Нейросети и ИИ
Стартап Elorian выпустил первую модель визуального рассуждения Glimpse
Пало-альто-стартап Elorian представил свою первую разработку — модель Glimpse, которая доступна в виде исследовательского превью с…
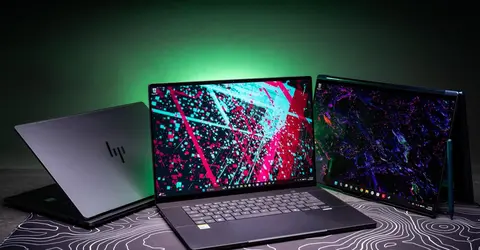
Первые тесты ноутбуков на чипе Nvidia RTX Spark
Nvidia выпустила новый Arm-процессор RTX Spark N1X для ноутбуков и компактных ПК, оснащенный графикой Nvidia RTX Blackwell и…
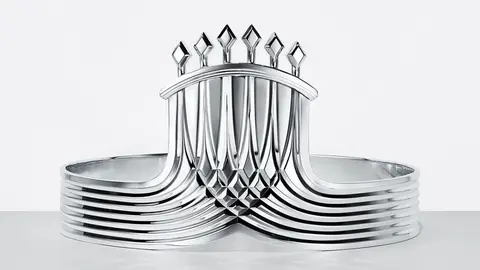
Стартап Veritas адаптировал защитный чип для ювелирных изделий
Стартап Veritas представил вторую версию своего защитного чипа от подделок, который теперь работает на металлических поверхностях и…
Прорыв в понимании нейросетей: эссе Ника Каммараты
Исследователь из лаборатории Goodfire Ник Каммарата опубликовал эссе, в котором утверждает, что внутренняя структура больших ИИ-моделей…
🧠 Нейросети и ИИ — каждый день
Самое важное из мира ИИ коротко и по-русски. Подписывайтесь на канал «Нейрон дня» в Telegram.
Открыть канал →